Cuando entrenamos un modelo de Machine Learning, normalmente existen diferentes valores que podemos modificar para controlar su comportamiento. Por ejemplo, podemos decidir la complejidad de los árboles de un Gradient Boosting, la velocidad con la que aprende el modelo o el número mínimo de observaciones que debe contener cada hoja.
A estos valores los llamamos hiperparámetros.
A diferencia de los parámetros internos del modelo, que son aprendidos automáticamente durante el entrenamiento, los hiperparámetros debemos establecerlos nosotros antes de entrenar. Una estrategia habitual consiste en probar diferentes combinaciones y quedarnos con aquella que obtenga mejores resultados mediante validación cruzada.
Sin embargo, cuando tenemos varios hiperparámetros y muchos valores posibles, el número de combinaciones puede crecer rápidamente y el coste computacional puede llegar a ser considerable.
En este post compararemos dos herramientas de scikit-learn para realizar esta búsqueda:
- GridSearchCV, que prueba todas las combinaciones que indiquemos.
- RandomizedSearchCV, que prueba solamente un número limitado de combinaciones seleccionadas aleatoriamente.
Veremos con un ejemplo real cuánto tiempo podemos ahorrar y si necesariamente obtenemos peores resultados por probar menos configuraciones.
1. Dataset de inicio
Utilizaremos nuevamente el conocido dataset Breast Cancer Wisconsin (Diagnostic), disponible directamente en scikit-learn.
Es un conjunto de datos de clasificación binaria compuesto por 569 observaciones y 30 variables numéricas obtenidas a partir de imágenes digitalizadas de masas mamarias. Contiene 212 muestras clasificadas como malignas y 357 como benignas.
Lo cargamos de la siguiente forma:
from sklearn.datasets import load_breast_cancer

data = load_breast_cancer(as_frame=True)

X = data.data.copy()
y = data.target.copy()

print(X.shape)
print(y.value_counts())
Obtenemos:
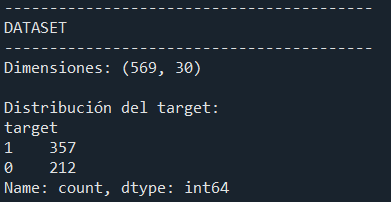
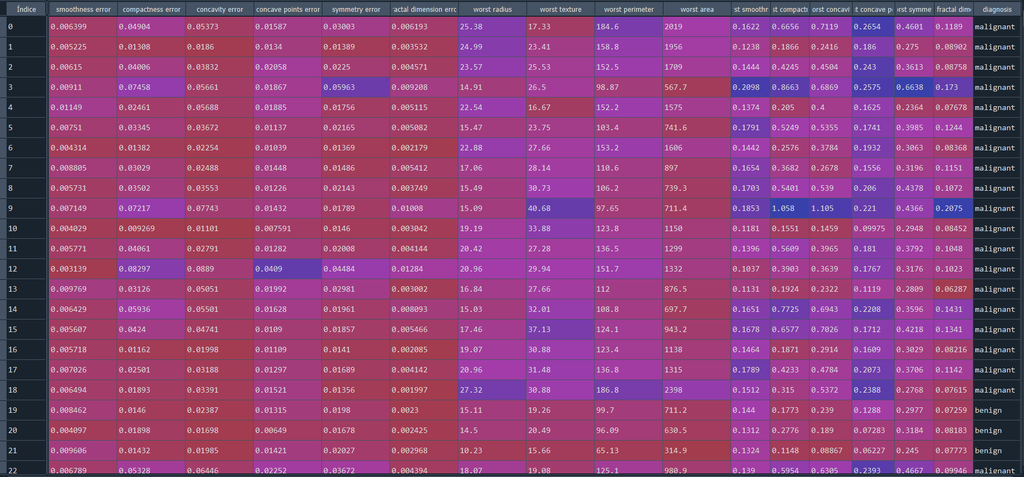
Podemos visualizar las primeras filas:
Dividimos los datos en un 80% para entrenamiento y un 20% para test:
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.20,
    stratify=y,
    random_state=42
)
Obtenemos:
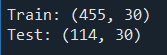
El conjunto de test queda completamente fuera del proceso de búsqueda de hiperparámetros. Lo utilizaremos únicamente al final para comprobar si el modelo generaliza correctamente sobre datos que no han participado en su entrenamiento ni en la selección de hiperparámetros.
2. Modelo utilizado: HistGradientBoostingClassifier
Para el ejemplo utilizaremos HistGradientBoostingClassifier, un modelo de clasificación basado en Gradient Boosting.
De forma muy simplificada, un Gradient Boosting construye sucesivamente pequeños árboles de decisión. Cada nuevo árbol intenta corregir parte de los errores cometidos por los anteriores, y la predicción final combina el resultado de todos ellos.
from sklearn.ensemble import HistGradientBoostingClassifier

base_model = HistGradientBoostingClassifier(
    max_iter=150,
    early_stopping=True,
    random_state=42
)
Antes de modificar nada, conviene disponer de un modelo de referencia o baseline. Esto nos permitirá comprobar posteriormente si todo el proceso de optimización ha servido realmente para mejorar algo.
Utilizaremos ROC AUC como métrica y validación cruzada estratificada con 5 particiones:
from sklearn.model_selection import StratifiedKFold, cross_val_score

cv = StratifiedKFold(
    n_splits=5,
    shuffle=True,
    random_state=42
)

baseline_scores = cross_val_score(
    base_model,
    X_train,
    y_train,
    scoring="roc_auc",
    cv=cv,
    n_jobs=-1
)
El resultado obtenido ha sido:
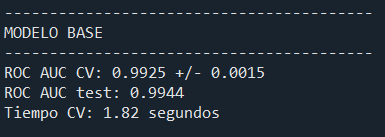
Nuestro modelo base funciona ya bastante bien. Precisamente por ello será interesante comprobar cuánto conseguimos mejorar realizando una búsqueda de hiperparámetros.
3. Hiperparámetros que vamos a probar
Vamos a modificar cinco hiperparámetros de HistGradientBoostingClassifier:
param_space = {

    "learning_rate": [
        0.03,
        0.05,
        0.10
    ],

    "max_leaf_nodes": [
        7,
        15,
        31
    ],

    "min_samples_leaf": [
        10,
        20
    ],

    "l2_regularization": [
        0.0,
        0.1,
        1.0
    ],

    "early_stopping": [
        True,
        False
    ]
}
Veamos brevemente qué significa cada uno.
learning_rate
learning_rate controla cuánto aporta cada nuevo árbol al conjunto.
Un valor pequeño hace que cada árbol modifique poco el modelo, por lo que normalmente serán necesarias más iteraciones. Un valor mayor permite aprender más rápidamente, aunque valores excesivamente altos pueden hacer que el modelo avance demasiado deprisa y generalice peor.
Existe, por tanto, una relación importante entre learning_rate y el número de iteraciones del boosting.
max_leaf_nodes
max_leaf_nodes establece el número máximo de hojas que puede tener cada árbol.
Una hoja es el nodo final de una rama del árbol, donde termina una determinada división de los datos.
Cuantas más hojas permitamos, más complejo puede ser el árbol y más patrones puede aprender. Sin embargo, aumentar excesivamente la complejidad también puede facilitar el overfitting.
min_samples_leaf
min_samples_leaf establece el número mínimo de observaciones que debe contener una hoja.
Por ejemplo, con:
min_samples_leaf = 20
no permitimos que el árbol cree una hoja final que contenga menos de 20 registros.
Valores pequeños permiten crear árboles más específicos y complejos. Valores mayores obligan al modelo a crear divisiones más generales.
l2_regularization
La regularización intenta evitar que el modelo se adapte excesivamente a los datos de entrenamiento.
l2_regularization introduce una penalización sobre los valores de las hojas del modelo. Un valor de 0 significa que no aplicamos esta regularización.
early_stopping
El early stopping o parada temprana detiene el entrenamiento cuando el modelo deja de mejorar suficientemente sobre unos datos de validación.
La idea es sencilla: si seguir añadiendo árboles ya no mejora el modelo, podemos detenernos antes de alcanzar el número máximo de iteraciones.
Esto puede reducir tiempo de entrenamiento y también ayudar a evitar un ajuste excesivo.
4. ¿Qué es el overfitting?
Antes de continuar conviene aclarar un concepto que aparece continuamente al ajustar hiperparámetros.
Hablamos de overfitting o sobreajuste cuando un modelo aprende demasiado bien los datos utilizados durante el entrenamiento, incluyendo peculiaridades o ruido que no se repetirán necesariamente en nuevos datos.
Un modelo con overfitting puede obtener resultados excelentes durante entrenamiento o validación, pero empeorar cuando recibe datos realmente nuevos.
El objetivo no es conseguir el modelo que mejor memorice nuestro conjunto de datos, sino aquel que mejor generalice.
Precisamente por ello usamos validación cruzada durante el ajuste de hiperparámetros y reservamos un conjunto de test independiente para la evaluación final.
5. GridSearchCV: probar todas las combinaciones
GridSearchCV realiza una búsqueda exhaustiva: prueba todas las combinaciones posibles que hemos definido en nuestra rejilla de hiperparámetros.
En nuestro ejemplo tenemos:
learning_rate -> 3 valores
max_leaf_nodes -> 3 valores
min_samples_leaf -> 2 valores
l2_regularization -> 3 valores
early_stopping -> 2 valores
Por tanto:
3 x 3 x 2 x 3 x 2 = 108 combinaciones
Podemos configurarlo así:
from sklearn.model_selection import GridSearchCV

grid_model = HistGradientBoostingClassifier(
    max_iter=150,
    random_state=42
)

grid = GridSearchCV(
    estimator=grid_model,
    param_grid=param_space,
    scoring="roc_auc",
    cv=cv,
    n_jobs=-1,
    refit=True
)

grid.fit(X_train, y_train)
Pero además estamos utilizando validación cruzada con 5 folds.
Esto significa que cada una de las 108 configuraciones debe entrenarse cinco veces:
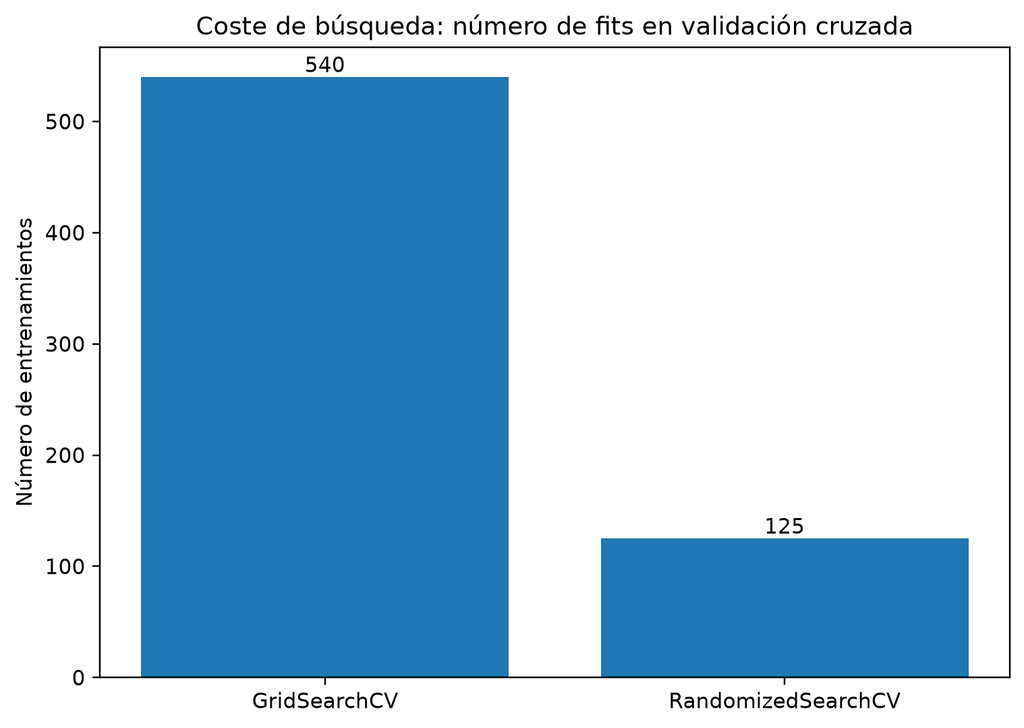
108 x 5 = 540 entrenamientos
Después de la validación cruzada, GridSearchCV vuelve a entrenar el modelo utilizando la mejor combinación encontrada sobre todo el conjunto de entrenamiento. En nuestro caso, evaluar las 108 combinaciones con 5 folds supone realizar 540 entrenamientos solamente durante la validación cruzada.
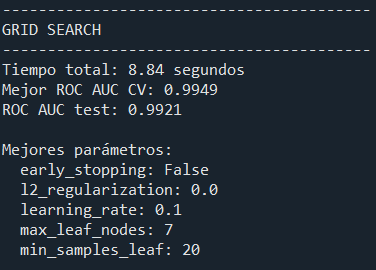
El mejor resultado y los hiperparámetros obtenidos con GridSearchCV han sido:
6. RandomizedSearchCV: probar solo una parte
El problema de GridSearch aparece cuando aumentamos el número de hiperparámetros o los valores posibles.
Supongamos que añadimos solamente cinco valores a cada uno de cinco hiperparámetros:
5 x 5 x 5 x 5 x 5 = 3125 combinaciones
Con validación cruzada de 5 folds tendríamos:
3125 x 5 = 15625 entrenamientos
La búsqueda puede empezar a resultar cara rápidamente.
RandomizedSearchCV adopta una estrategia diferente. En lugar de evaluar todas las combinaciones posibles, selecciona aleatoriamente un número concreto de configuraciones indicado mediante n_iter.
En nuestro caso hemos decidido probar solamente 25:
from sklearn.model_selection import RandomizedSearchCV

random_model = HistGradientBoostingClassifier(
    max_iter=150,
    random_state=42
)

random_search = RandomizedSearchCV(
    estimator=random_model,
    param_distributions=param_space,
    n_iter=25,
    scoring="roc_auc",
    cv=cv,
    random_state=42,
    n_jobs=-1,
    refit=True
)

random_search.fit(X_train, y_train)
Por tanto, necesitamos:
25 configuraciones x 5 folds = 125 entrenamientos
frente a los 540 de GridSearch.
En este caso, el mejor resultado y los hiperparámetros obtenidos con RandomizedSearchCV han sido:
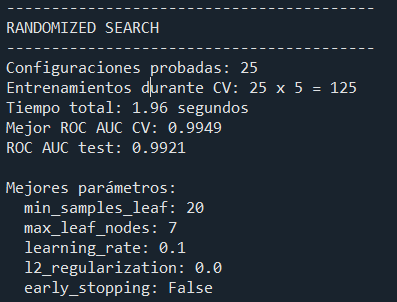
Exactamente la misma combinación que GridSearchCV.
7. Comparación del coste
Los resultados obtenidos son los siguientes:
| Método | Configuraciones | Fits CV | Tiempo | AUC CV | AUC test |
|---|---|---|---|---|---|
| Baseline | 1 | 5 | 1,82 s | 0,9925 | 0,9944 |
| GridSearchCV | 108 | 540 | 8,84 s | 0,9949 | 0,9921 |
| RandomizedSearchCV | 25 | 125 | 1,96 s | 0,9949 | 0,9921 |
RandomizedSearchCV ha reducido el número de entrenamientos en un 76,9%, y en nuestro equipo el tiempo empleado ha pasado de 8,84s con GridSearchCV a 1,96s con RandomizedSearchCV.
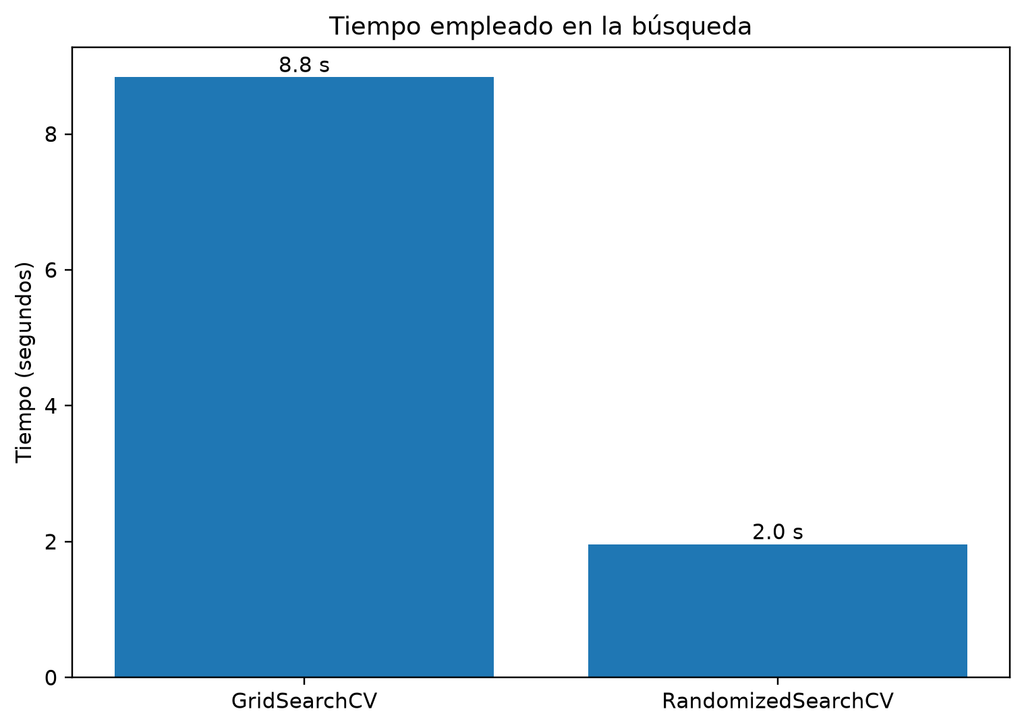
Los tiempos concretos dependerán obviamente del ordenador utilizado, del número de procesadores, del dataset y del modelo. Lo realmente interesante aquí es la diferencia relativa entre ambas estrategias.
Y lo mejor de todo es que, en nuestro experimento, esa reducción del coste no ha supuesto ninguna pérdida de rendimiento. RandomizedSearch encontró, probando solamente 25 de las 108 posibilidades, exactamente la misma configuración óptima que GridSearch.
8. ¿Ha mejorado realmente el modelo?
Llegamos a una parte especialmente interesante del ejemplo.
Nuestro modelo inicial obtenía:
Baseline
AUC CV: 0.9925
AUC test: 0.9944
Después del ajuste de hiperparámetros:
GridSearch/RandomizedSearch
AUC CV: 0.9949
AUC test: 0.9921
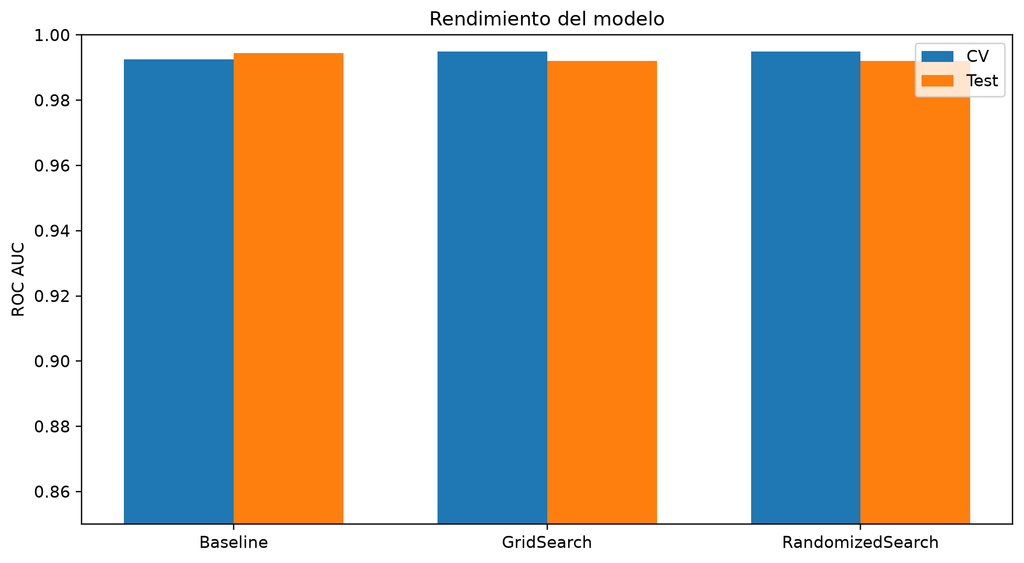
Si miramos exclusivamente la validación cruzada podríamos concluir que hemos mejorado:
0.9925 -> 0.9949
Sin embargo, cuando aplicamos el modelo sobre el conjunto de test ocurre lo contrario:
0.9944 -> 0.9921
La diferencia es muy pequeña, por lo que no sería correcto afirmar que hemos provocado un overfitting importante.
Pero sí tenemos una enseñanza interesante: optimizar hiperparámetros no garantiza automáticamente que el modelo vaya a funcionar mejor sobre datos nuevos.
Estamos seleccionando la configuración que mejor resultado ha obtenido durante nuestra validación cruzada. En conjuntos de datos relativamente pequeños, diferencias mínimas pueden deberse simplemente a la variabilidad de las muestras utilizadas.
Por eso es tan importante mantener el conjunto de test completamente independiente hasta el final.
9. ¿Qué hiperparámetros han tenido mayor efecto?
Podemos aprovechar todos los resultados de GridSearchCV para observar cómo se ha comportado el modelo con diferentes valores.
En el caso de learning_rate obtenemos:
learning_rate    AUC medio    Mejor AUC
0.03             0.9903       0.9920
0.05             0.9917       0.9940
0.10             0.9927       0.9949
Dentro de los valores que hemos probado, learning_rate=0.1 ha funcionado mejor.
Esto no significa que 0.1 sea siempre el mejor valor para Gradient Boosting. Simplemente ha sido el mejor dentro de nuestro problema y de nuestra búsqueda concreta.
Para max_leaf_nodes:
max_leaf_nodes    AUC medio    Mejor AUC
7                 0.9918       0.9949
15                0.9915       0.9947
31                0.9915       0.9945
En nuestro ejemplo, permitir árboles más complejos no ha supuesto una mejora. De hecho, el mejor resultado se alcanza limitándolos a 7 hojas.
Por último:
min_samples_leaf    AUC medio    Mejor AUC
10                  0.9915       0.9945
20                  0.9917       0.9949
Las diferencias son muy pequeñas, aunque 20 obtiene ligeramente mejores resultados.
Este análisis también ilustra algo importante: no todos los hiperparámetros afectan de la misma manera al rendimiento. Scikit-learn señala precisamente que es habitual que solo una pequeña parte de ellos tenga un impacto importante, mientras que otros pueden mantenerse en sus valores por defecto.
10. ¿GridSearchCV o RandomizedSearchCV?
No existe una respuesta única. GridSearchCV puede ser adecuado cuando:
- Tenemos pocos hiperparámetros.
- Cada uno tiene pocos valores posibles.
- El modelo es rápido de entrenar.
- Queremos comprobar exhaustivamente una zona pequeña y concreta.
RandomizedSearchCV resulta especialmente interesante cuando:
- Tenemos muchos hiperparámetros.
- El espacio de búsqueda es grande.
- Entrenar el modelo es costoso.
- Tenemos un presupuesto limitado de tiempo o recursos.
- Queremos explorar primero una zona amplia y después afinar la búsqueda.
Una posible estrategia práctica consiste precisamente en combinar ambas ideas: comenzar con una búsqueda aleatoria relativamente amplia y, una vez localizada una zona prometedora, realizar una búsqueda más detallada alrededor de esos valores.
Conclusión
En este ejemplo hemos comparado dos formas diferentes de buscar los hiperparámetros de un modelo HistGradientBoostingClassifier.
GridSearchCV ha probado exhaustivamente las 108 combinaciones definidas. Utilizando validación cruzada de 5 folds esto ha supuesto 540 entrenamientos.
RandomizedSearchCV ha probado solamente 25 configuraciones, necesitando 125 entrenamientos.
Esto ha permitido reducir aproximadamente un 77% tanto el número de entrenamientos como el tiempo empleado.
Y, en nuestro caso concreto, RandomizedSearchCV ha encontrado exactamente la misma combinación de hiperparámetros y el mismo ROC AUC que GridSearchCV.
Pero el ejemplo nos ha dejado además otra enseñanza importante: aunque ambos métodos mejoraron ligeramente el resultado de validación cruzada respecto al modelo inicial, ninguno consiguió superar al baseline en el conjunto de test.
Por tanto, hacer una búsqueda más compleja de hiperparámetros no garantiza automáticamente un mejor modelo.
En resumen:
- Los hiperparámetros controlan el comportamiento del algoritmo y no son aprendidos directamente durante el entrenamiento.
- GridSearchCV prueba exhaustivamente todas las combinaciones indicadas.
- RandomizedSearchCV permite limitar de antemano cuántas configuraciones queremos evaluar.
- El coste de GridSearch crece multiplicativamente al añadir valores e hiperparámetros.
- Una búsqueda aleatoria puede encontrar soluciones iguales o muy próximas utilizando muchos menos recursos.
- La optimización debe evaluarse finalmente sobre datos independientes.
- Más búsqueda no significa necesariamente mejor generalización.
En problemas pequeños, GridSearch puede ser perfectamente asumible. Pero cuando entrenar cada modelo empieza a ser costoso, RandomizedSearchCV puede ser una forma mucho más eficiente de invertir nuestro presupuesto computacional.