Cuando trabajamos con un dataset podemos encontrarnos con variables que contienen información muy parecida. Por ejemplo, si tenemos el radio, el perímetro y el área de un objeto, es razonable esperar que exista una relación muy fuerte entre estas tres medidas.
Cuando varias variables predictoras están fuertemente relacionadas entre sí hablamos de multicolinealidad.
Esto puede convertirse en un problema, sobre todo en modelos lineales, porque resulta difícil separar cuánto aporta realmente cada variable al modelo. En este post veremos un ejemplo real para comprobar cómo detectar la multicolinealidad mediante:
- Matrices de correlaciones.
- Representaciones gráficas.
- El Variance Inflation Factor (VIF).
También veremos qué ocurre cuando eliminamos algunas de las variables redundantes.
1. Nuestro dataset
Para el ejemplo utilizaremos el conocido dataset Breast Cancer Wisconsin (Diagnostic), disponible directamente desde scikit-learn.
El conjunto contiene 569 observaciones y 30 variables numéricas obtenidas a partir de imágenes digitalizadas de masas mamarias. El objetivo consiste en clasificar los casos entre tumores malignos y benignos. En el dataset hay 212 casos malignos y 357 benignos.
Podemos cargarlo de forma directa y sencilla así:
from sklearn.datasets import load_breast_cancer

data = load_breast_cancer(as_frame=True)

df = data.frame.copy()

df["diagnosis"] = df["target"].map({
    0: "malignant",
    1: "benign"
})

df = df.drop(columns="target")

print(df.head())
Obtenemos un dataframe de 569 filas y 31 columnas: las 30 variables originales y nuestra columna target llamada diagnosis.
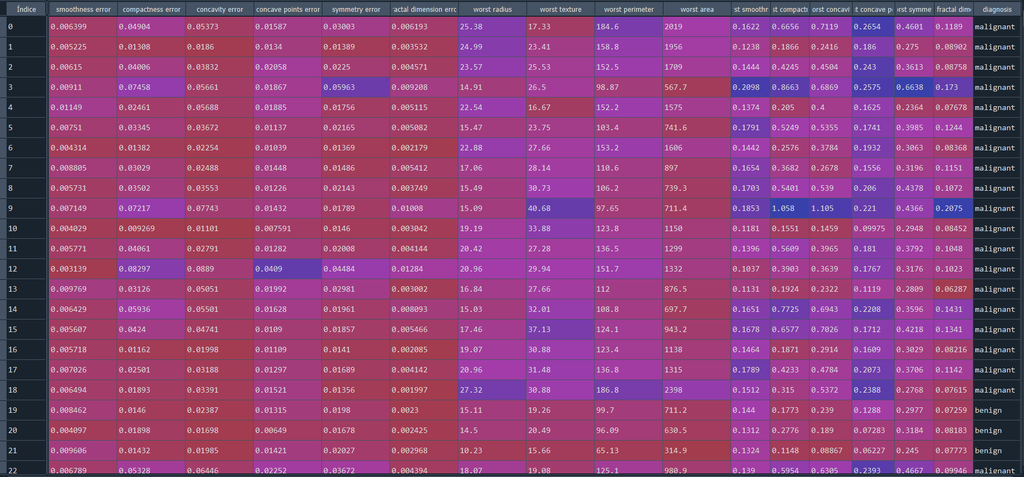
Para simplificar el ejemplo no trabajaremos con las 30 variables. Seleccionamos únicamente estas cinco:
selected_features = [
    "mean radius",
    "mean perimeter",
    "mean area",
    "mean texture",
    "mean smoothness"
]

df_selected = df[selected_features].copy()
Las tres primeras describen diferentes características relacionadas con el tamaño de la masa y, como veremos, contienen información muy similar.
2. Correlación entre variables
Una primera forma sencilla de detectar posibles variables redundantes consiste en calcular su matriz de correlaciones:
corr_matrix = df_selected.corr()

print(corr_matrix.round(3))
Obtenemos:
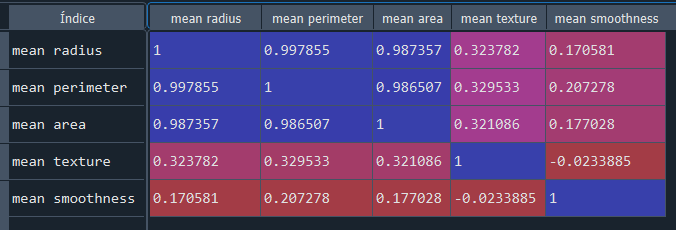
Se observan correlaciones extremadamente elevadas entre:
mean radiusymean perimeter: 0,9979.mean radiusymean area: 0,9874.mean perimeterymean area: 0,9865.
Podemos visualizarlo mediante un mapa de correlaciones:
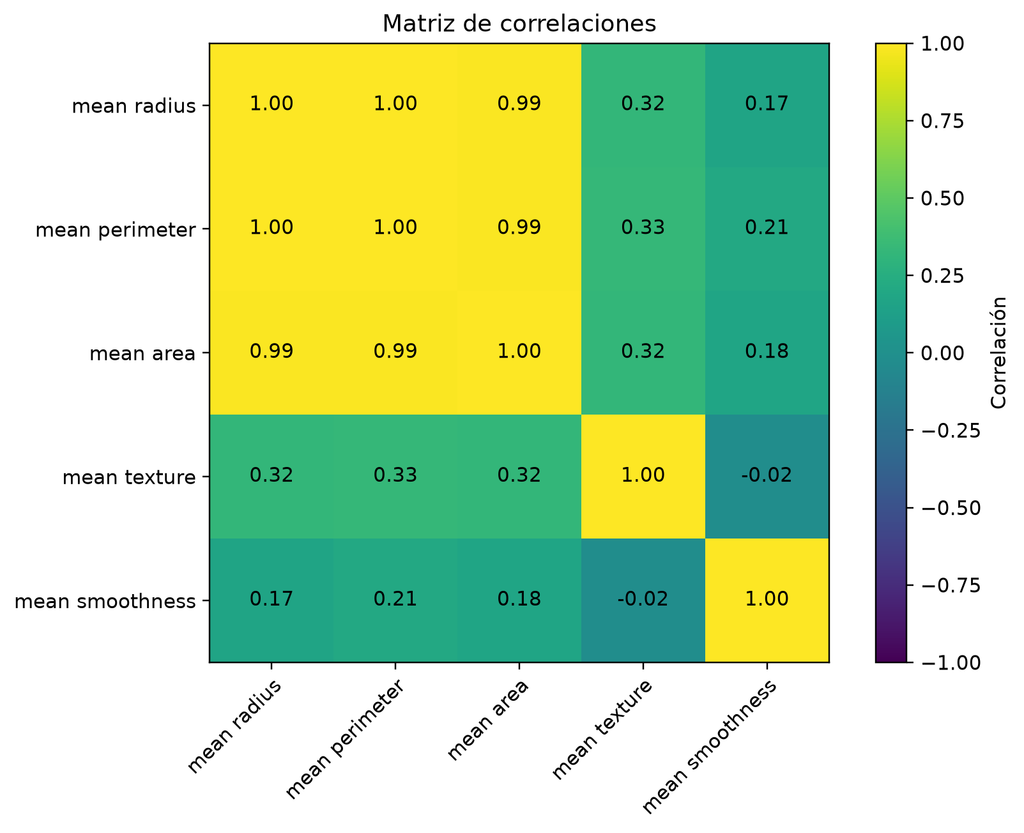
Hay que señalar que en la imagen la correlación entre mean radius y mean perimeter aparece redondeada como 1,00, aunque su valor real es 0,9979.
Las variables mean texture y mean smoothness, por el contrario, presentan relaciones mucho más débiles con las tres anteriores.
3. Visualización de dos variables muy correlacionadas
Podemos comprobar de una forma todavía más visual la relación entre mean radius y mean perimeter mediante un diagrama de dispersión:
import matplotlib.pyplot as plt

plt.figure(figsize=(8, 6))

plt.scatter(
    df["mean radius"],
    df["mean perimeter"],
    alpha=0.6
)

plt.xlabel("Mean radius")
plt.ylabel("Mean perimeter")
plt.title("Relación entre mean radius y mean perimeter")

plt.tight_layout()
plt.show()
El resultado es el siguiente:
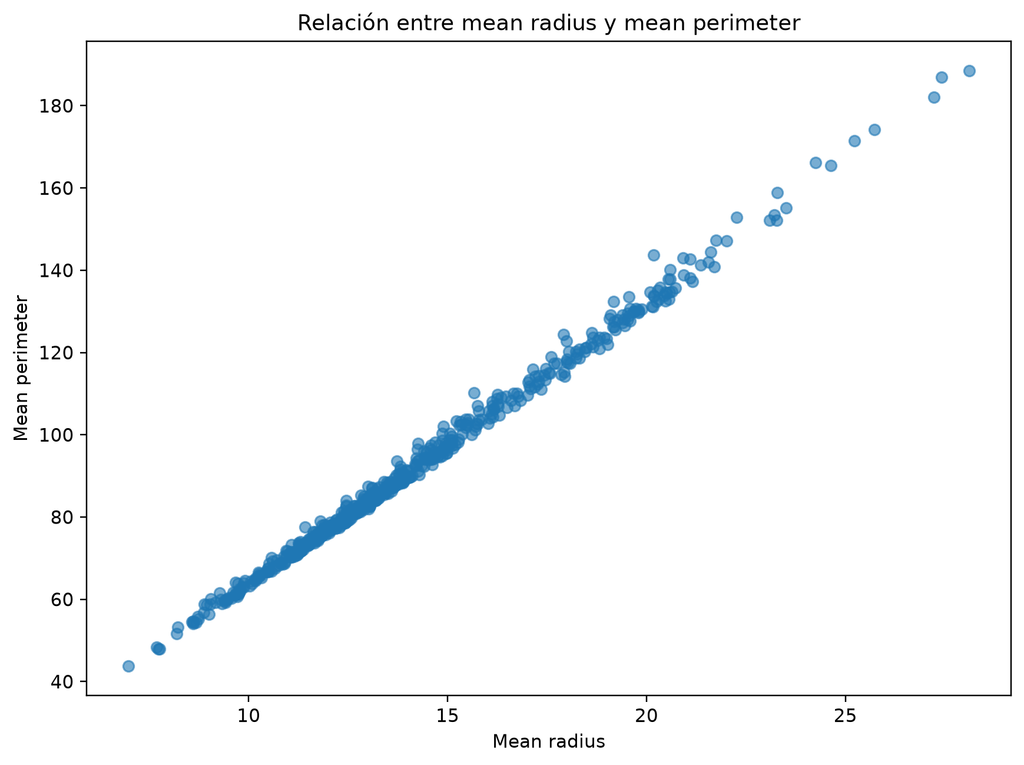
Los puntos forman prácticamente una línea recta. Esto significa que conociendo una de las variables podemos estimar con bastante precisión la otra.
Por tanto, ambas están aportando al modelo una información muy parecida.
Sin embargo, observar correlaciones altas entre pares de variables no siempre es suficiente para estudiar la multicolinealidad. Para analizar hasta qué punto una variable puede ser explicada por el conjunto de las demás podemos utilizar el Variance Inflation Factor.
4. Variance Inflation Factor (VIF)
El Variance Inflation Factor, normalmente abreviado como VIF, mide cuánto aumenta la varianza estimada de un coeficiente debido a la relación entre una variable predictora y el resto de predictores.
Cuanto mayor sea el VIF, mayor será la multicolinealidad asociada a esa variable.
Como regla orientativa, la documentación de statsmodels indica que un VIF superior a 5 puede considerarse una señal de alta colinealidad y puede provocar errores estándar elevados en la estimación de los parámetros. No debe entenderse como una frontera matemática absoluta, sino como una referencia práctica.
Podemos calcularlo con variance_inflation_factor() de statsmodels:
import statsmodels.api as sm
from statsmodels.stats.outliers_influence import variance_inflation_factor

def calculate_vif(dataframe):

    X = sm.add_constant(dataframe)

    vif = pd.DataFrame({
        "variable": X.columns,
        "VIF": [
            variance_inflation_factor(X.values, i)
            for i in range(X.shape[1])
        ]
    })

    vif = vif[vif["variable"] != "const"]

    vif = vif.sort_values(
        by="VIF",
        ascending=False
    ).reset_index(drop=True)

    return vif
Aplicamos la función a nuestras cinco variables:
vif_before = calculate_vif(df_selected)

print(vif_before)
Obtenemos:
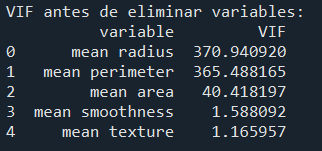
Los resultados son bastante claros.
mean radius y mean perimeter presentan valores superiores a 365, mientras que mean area supera 40. Son valores extraordinariamente elevados y confirman la fuerte redundancia que ya habíamos observado en la matriz de correlaciones.
Por el contrario, mean smoothness y mean texture tienen valores cercanos a 1.5.
5. Eliminación de variables redundantes
Una posible solución consiste en conservar una de las variables muy correlacionadas y eliminar las demás.
En este ejemplo vamos a conservar mean radius y eliminar mean perimeter y mean area:
features_reduced = [
    "mean radius",
    "mean texture",
    "mean smoothness"
]

df_reduced = df[features_reduced].copy()
Volvemos a calcular el VIF:
vif_after = calculate_vif(df_reduced)

print(vif_after)
El resultado es:
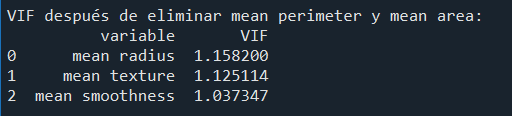
La diferencia es enorme.
mean radius pasa de un VIF de aproximadamente 371 a solo 1,16. Las tres variables restantes presentan ahora valores muy cercanos a 1, indicando que apenas existe multicolinealidad entre ellas.
6. ¿Debemos eliminar siempre variables correlacionadas?
No. Y este es probablemente el punto más importante de este post.
Encontrar dos variables con una correlación muy elevada no significa automáticamente que tengamos que eliminar una de ellas.
La multicolinealidad resulta especialmente problemática en modelos como una regresión lineal o una regresión logística, donde estamos interesados en interpretar los coeficientes de las variables.
Si dos variables contienen prácticamente la misma información, el modelo puede tener dificultades para decidir qué parte del efecto corresponde a cada una. Los coeficientes pueden volverse inestables y sus errores estándar aumentar.
Sin embargo, en modelos basados en árboles de decisión, Random Forest o Gradient Boosting, la multicolinealidad suele ser bastante menos problemática desde el punto de vista puramente predictivo. El modelo puede seleccionar una de las variables correlacionadas para realizar las divisiones sin que necesariamente se deteriore mucho su capacidad predictiva.
Por tanto, antes de eliminar una variable debemos tener en cuenta:
- Qué modelo vamos a utilizar.
- Si nuestro objetivo es principalmente predicción o también interpretación.
- Si ambas variables tienen algún significado relevante para el problema de negocio.
- Si al eliminar una de ellas empeora el rendimiento del modelo.
7. Correlación y multicolinealidad no son exactamente lo mismo
Aunque están muy relacionadas, conviene distinguir ambos conceptos.
La correlación estudia normalmente la relación entre dos variables.
Por ejemplo:
mean radius ↔ mean perimeter = 0,9979
El VIF, en cambio, estudia cuánto puede ser explicada una determinada variable mediante todas las demás variables predictoras conjuntamente.
Por eso una simple matriz de correlaciones es una buena primera herramienta de exploración, pero el VIF puede detectar relaciones redundantes más generales que no tienen por qué aparecer claramente observando únicamente pares de variables.
Conclusión
En este ejemplo hemos comprobado un caso muy claro de multicolinealidad utilizando un dataset real.
Las variables mean radius, mean perimeter y mean area presentan correlaciones cercanas a 1 y unos valores VIF extremadamente elevados. Después de conservar mean radius y eliminar las otras dos variables, todos los valores VIF pasan a estar próximos a 1.
Sin embargo, esto no significa que debamos eliminar automáticamente cualquier variable altamente correlacionada. La importancia de la multicolinealidad depende tanto del modelo utilizado como del objetivo del análisis.
En modelos lineales puede ser especialmente problemática si queremos interpretar sus coeficientes. En modelos basados en árboles suele tener bastante menos impacto desde el punto de vista predictivo.
En resumen, una estrategia razonable sería:
- Usar una matriz de correlaciones como primera aproximación.
- Calcular el VIF cuando trabajemos con modelos donde la multicolinealidad pueda afectar a la interpretación.
- Investigar el significado de las variables antes de eliminar ninguna.
- Comprobar finalmente si la eliminación mejora, empeora o apenas modifica el rendimiento del modelo.
La idea no es eliminar variables correlacionadas de forma automática, sino comprender qué información están aportando y cómo afecta esa redundancia al modelo que estamos utilizando.